Troubleshooting & résolution autonomes
Du premier signal au correctif vérifié
Un seul workflow de résolution pour tous les incidents. À chaque étape, travaillez aux côtés de l'agent ou prenez le relais. Décidez quelles étapes démarrent seules, et lesquelles attendent votre feu vert.
- Une résolution plus rapide Des heures deviennent des minutes, 24h/24.
- Moins d’escalades Un savoir-faire d’expert entre les mains de tous.
- De la capacité rendue à la roadmap Enfin du temps pour ce qui compte le plus.
- Tout le contexte dans le ticket Rien à refaire, personne à relancer.
- Chaque correctif revu et réversible Aucun agent qui fait des dégâts sur votre cluster.
Déclencheur
La même méthode, quel que soit l'intervenant.
Quelle que soit la manière dont la session de troubleshooting démarre, le workflow de résolution reste le même.
- Une alerte de votre stack de supervision Taux d’erreur qui grimpe, latence qui augmente, pods qui redémarrent, ou une synchronisation qui ne converge pas.
- Une personne qui décrit le problème En langage naturel, dans le chat.
Investigation analyse de la cause racine
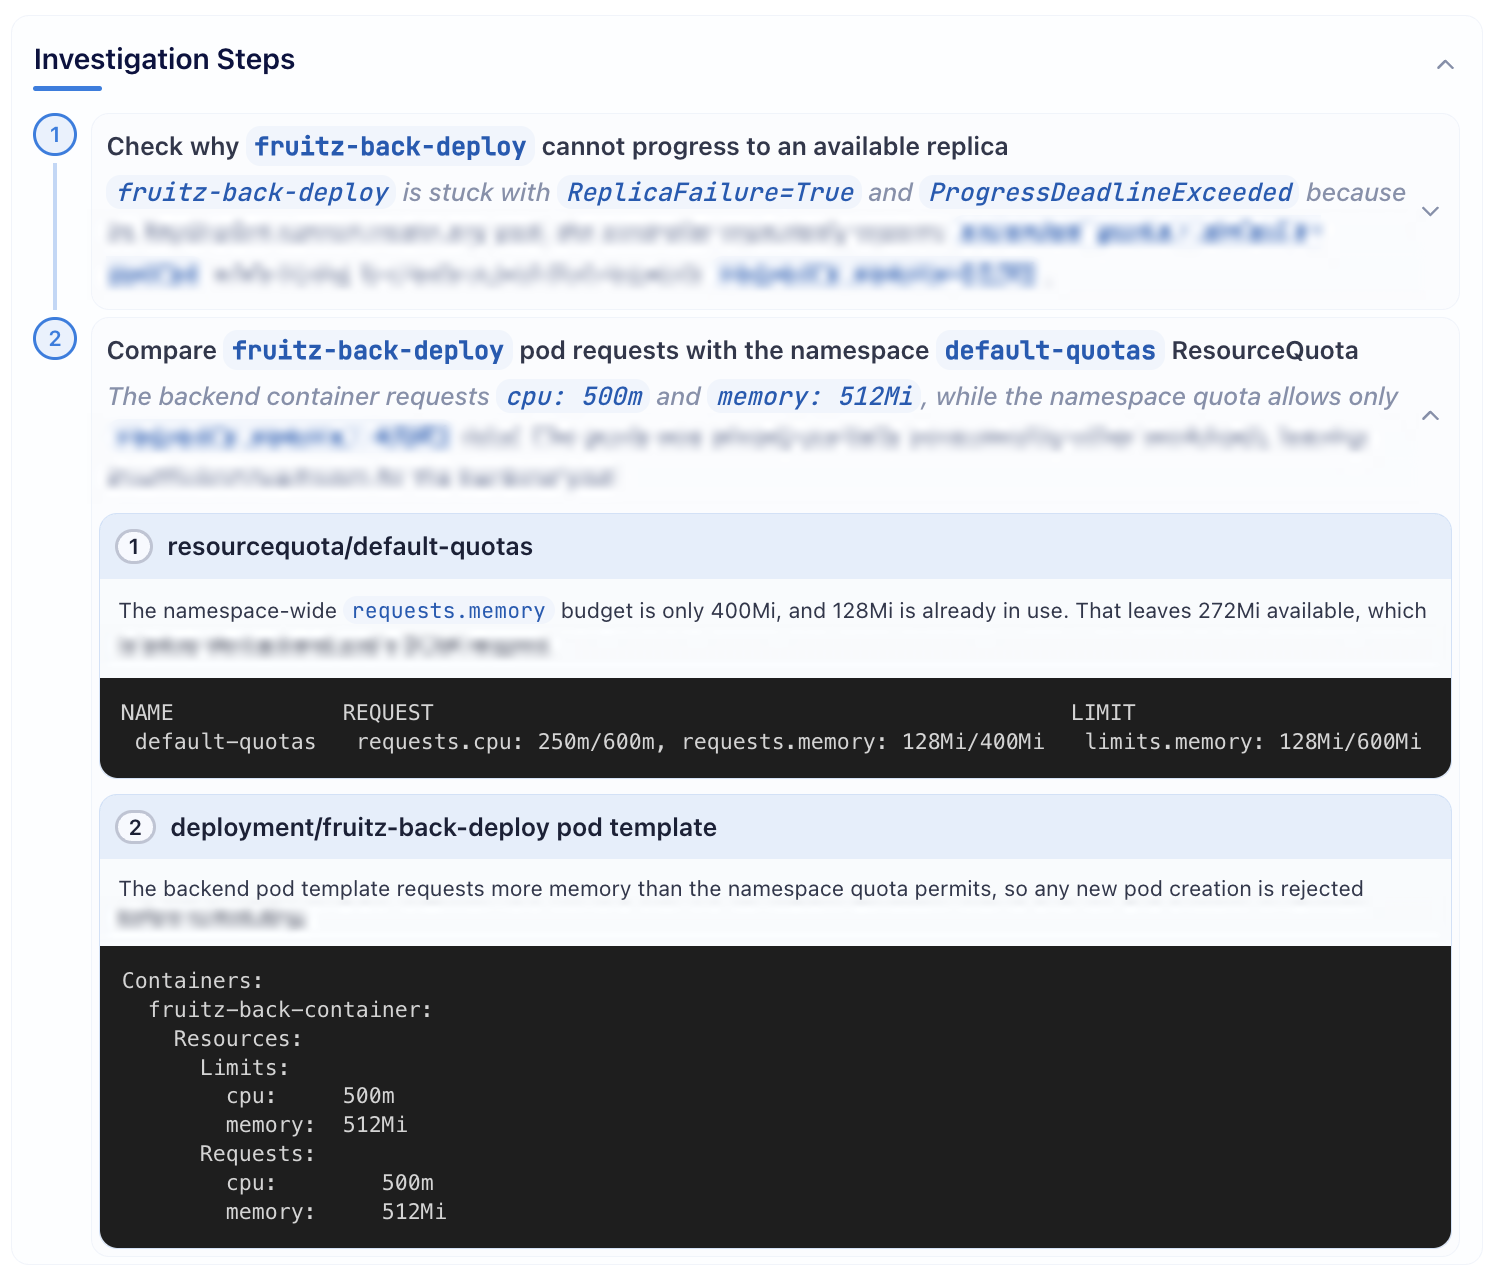
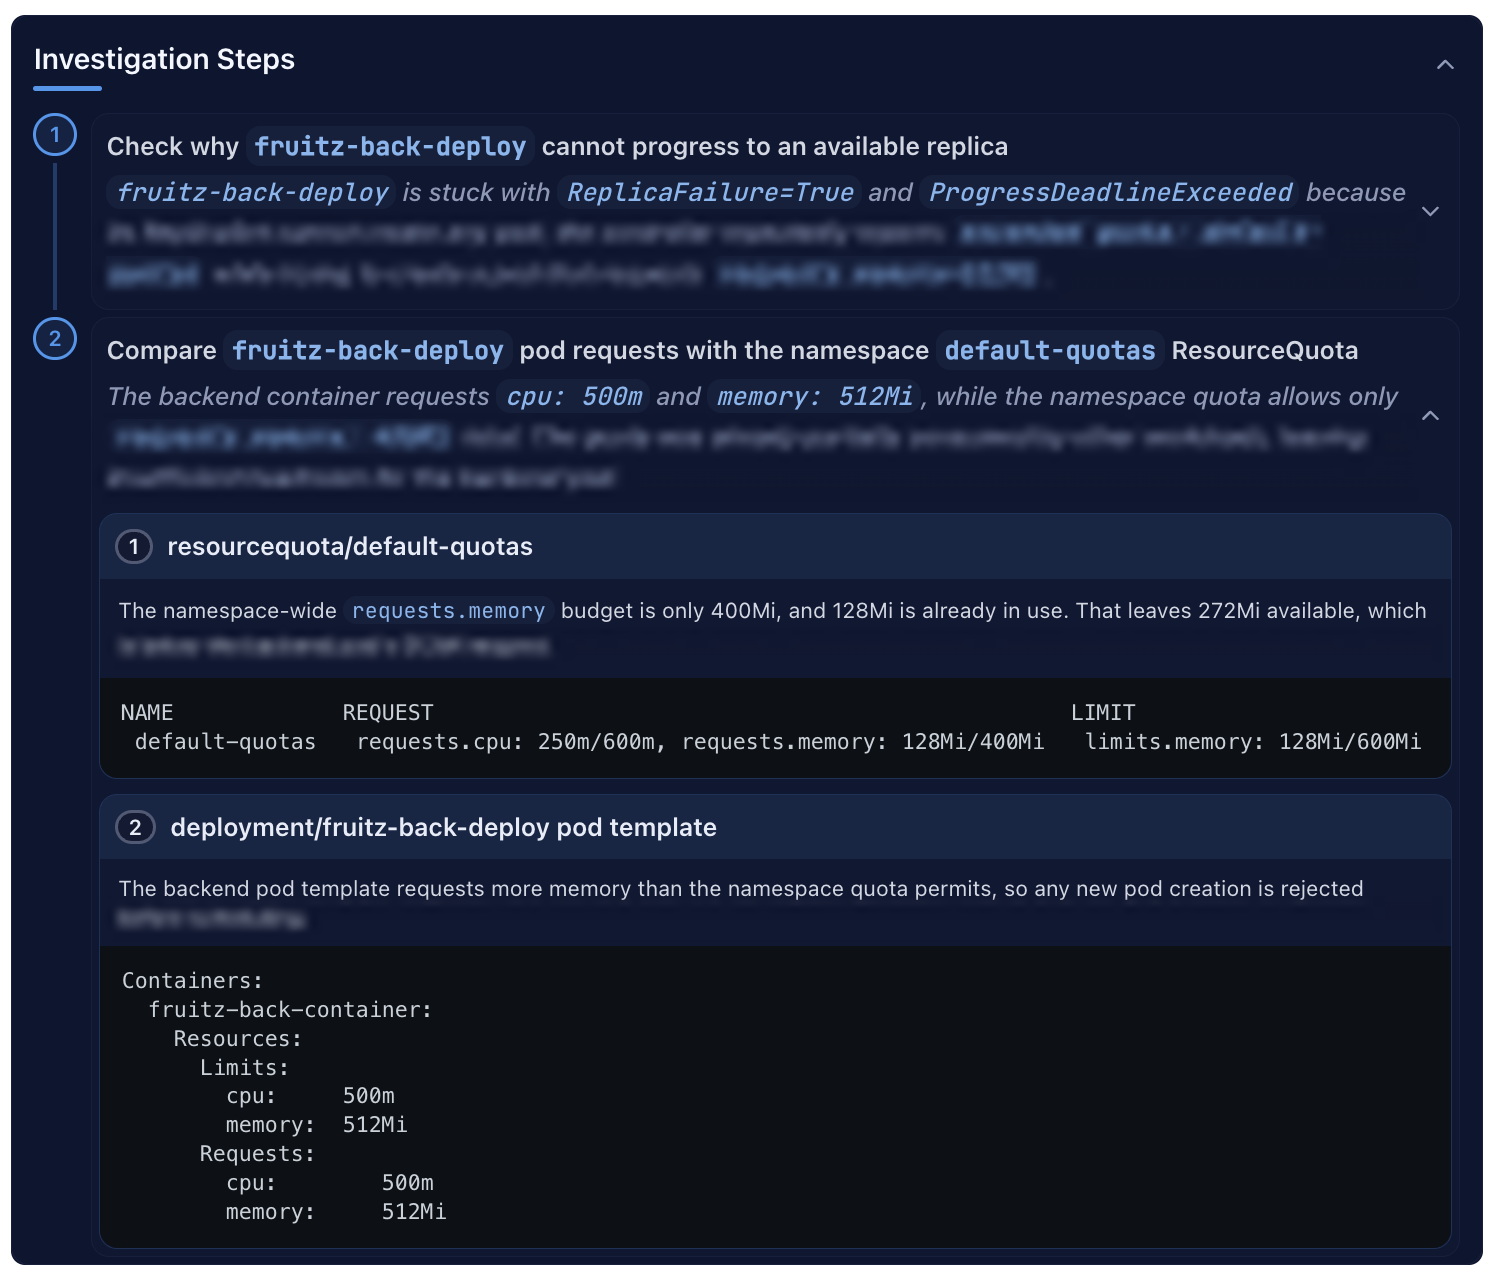
Investiguez plus vite, sans changer d'outil.
Sur une plateforme cloud-native, le troubleshooting d’un incident impose de chercher à travers de nombreux systèmes, couches, outils et technologies. Un processus lent et fastidieux, qui ne fait que ralentir à mesure que la plateforme grandit.
- Un troubleshooting sur toute la stack L’agent collecte et analyse les signaux opérationnels dispersés dans vos clusters Kubernetes, vos plateformes d’observabilité, vos outils de déploiement et l’état de vos releases. Il lit aussi d’autres sources, comme vos dépôts Git et la documentation technique.
- Une investigation autonome L’action suivante est décidée à partir de ce que l’agent vient de découvrir, sans suivre de scénario figé.
- Une analyse de la cause racine fondée sur des preuves L’agent documente sa progression dans un rapport de troubleshooting structuré : la description du problème, les étapes d’investigation avec leurs preuves, et l’analyse de la cause qui renvoie à ces étapes.
- Pilotez l’agent en direct Suivez l’investigation en cours, orientez l’agent vers ce qu’il n’a pas encore examiné, ou questionnez une conclusion.
- Explicable, traçable et auditable Le rapport de troubleshooting est conservé avec les observations sur lesquelles repose chaque conclusion. Les messages de la session sont enregistrés tels quels, ainsi que chaque action de l’agent et son résultat.
- Une escalade exploitable Lorsque la cause ne peut pas être établie, le rapport contient malgré tout ce qui a été investigué, observé et écarté. Celui qui reprend le dossier part d’un cas documenté, pas d’une page blanche.
- Partagez votre session Invitez des collègues à investiguer l’incident avec vous. Ils voient le même rapport et les mêmes messages que vous.
Conception de la solution & revue
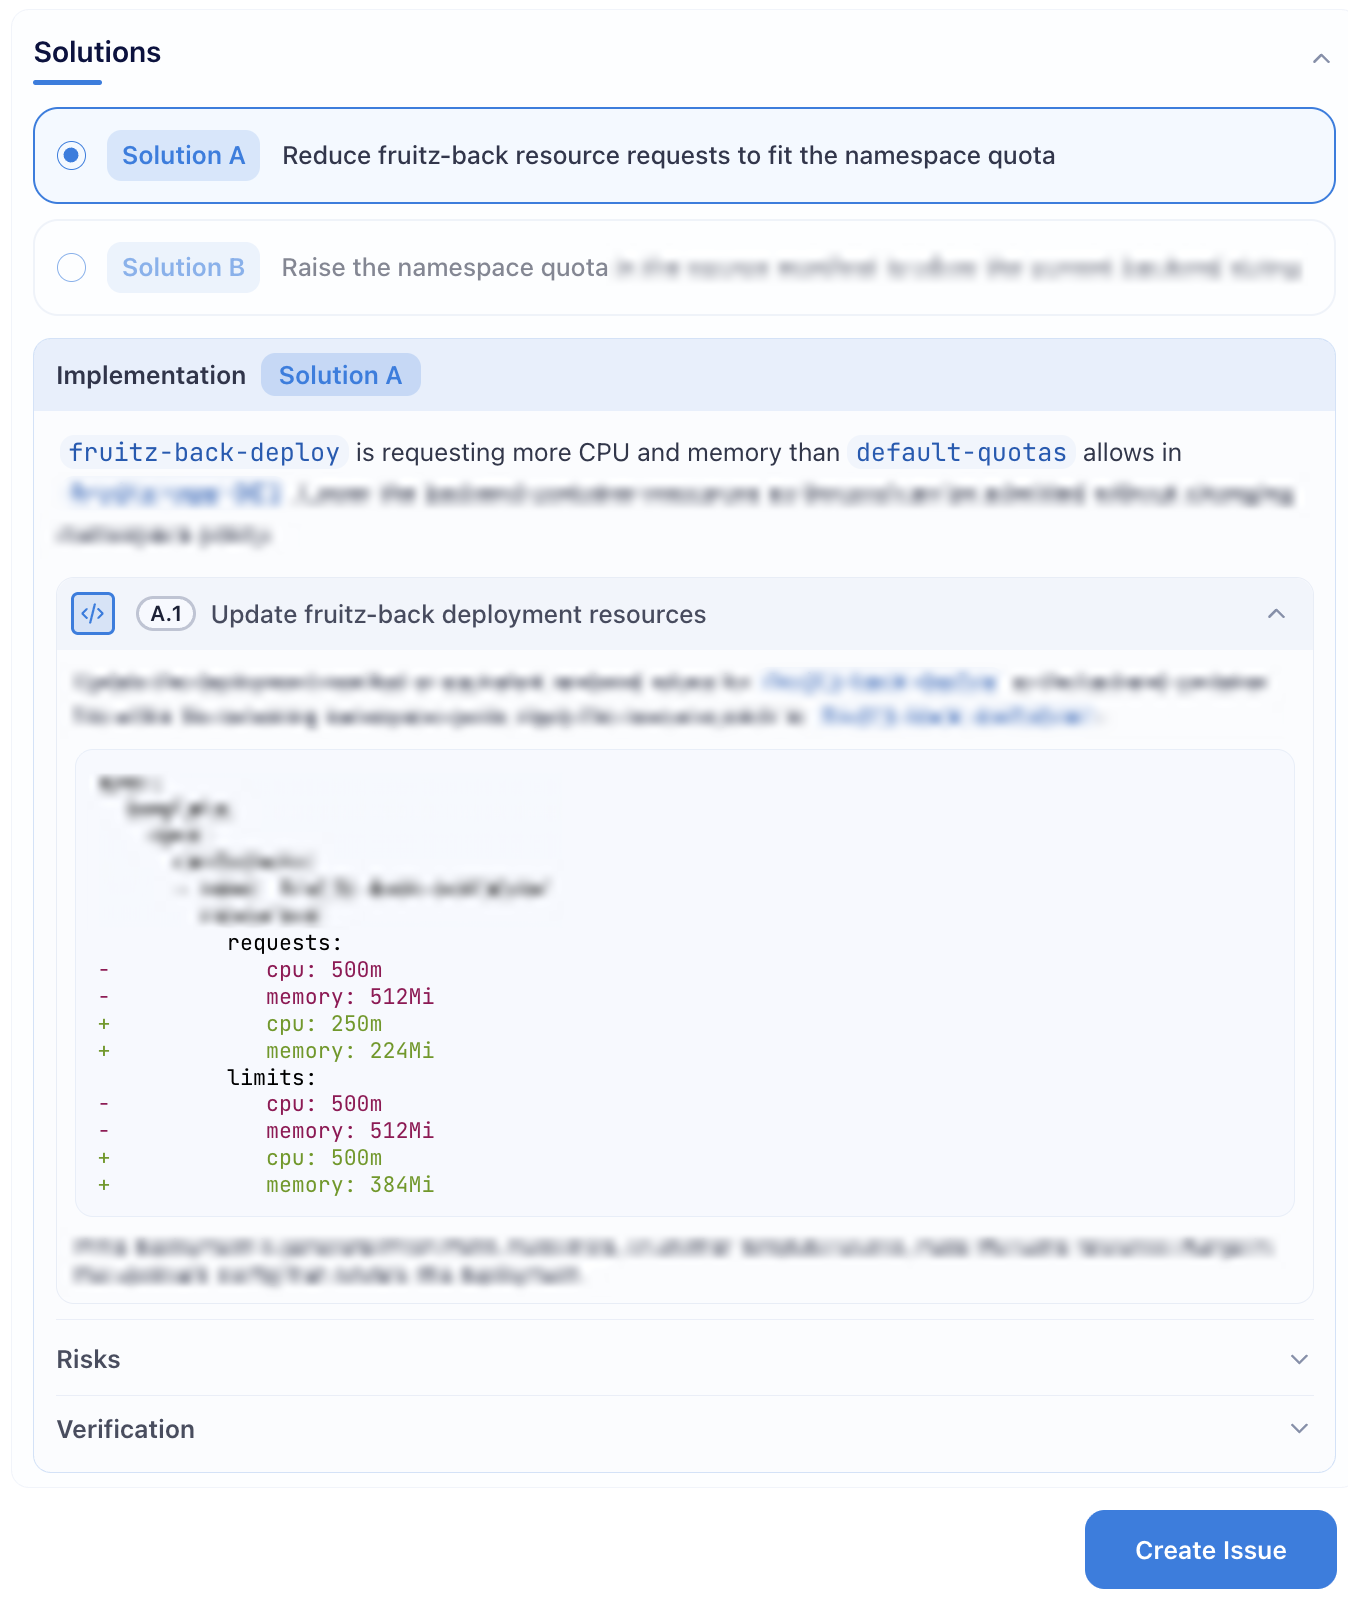
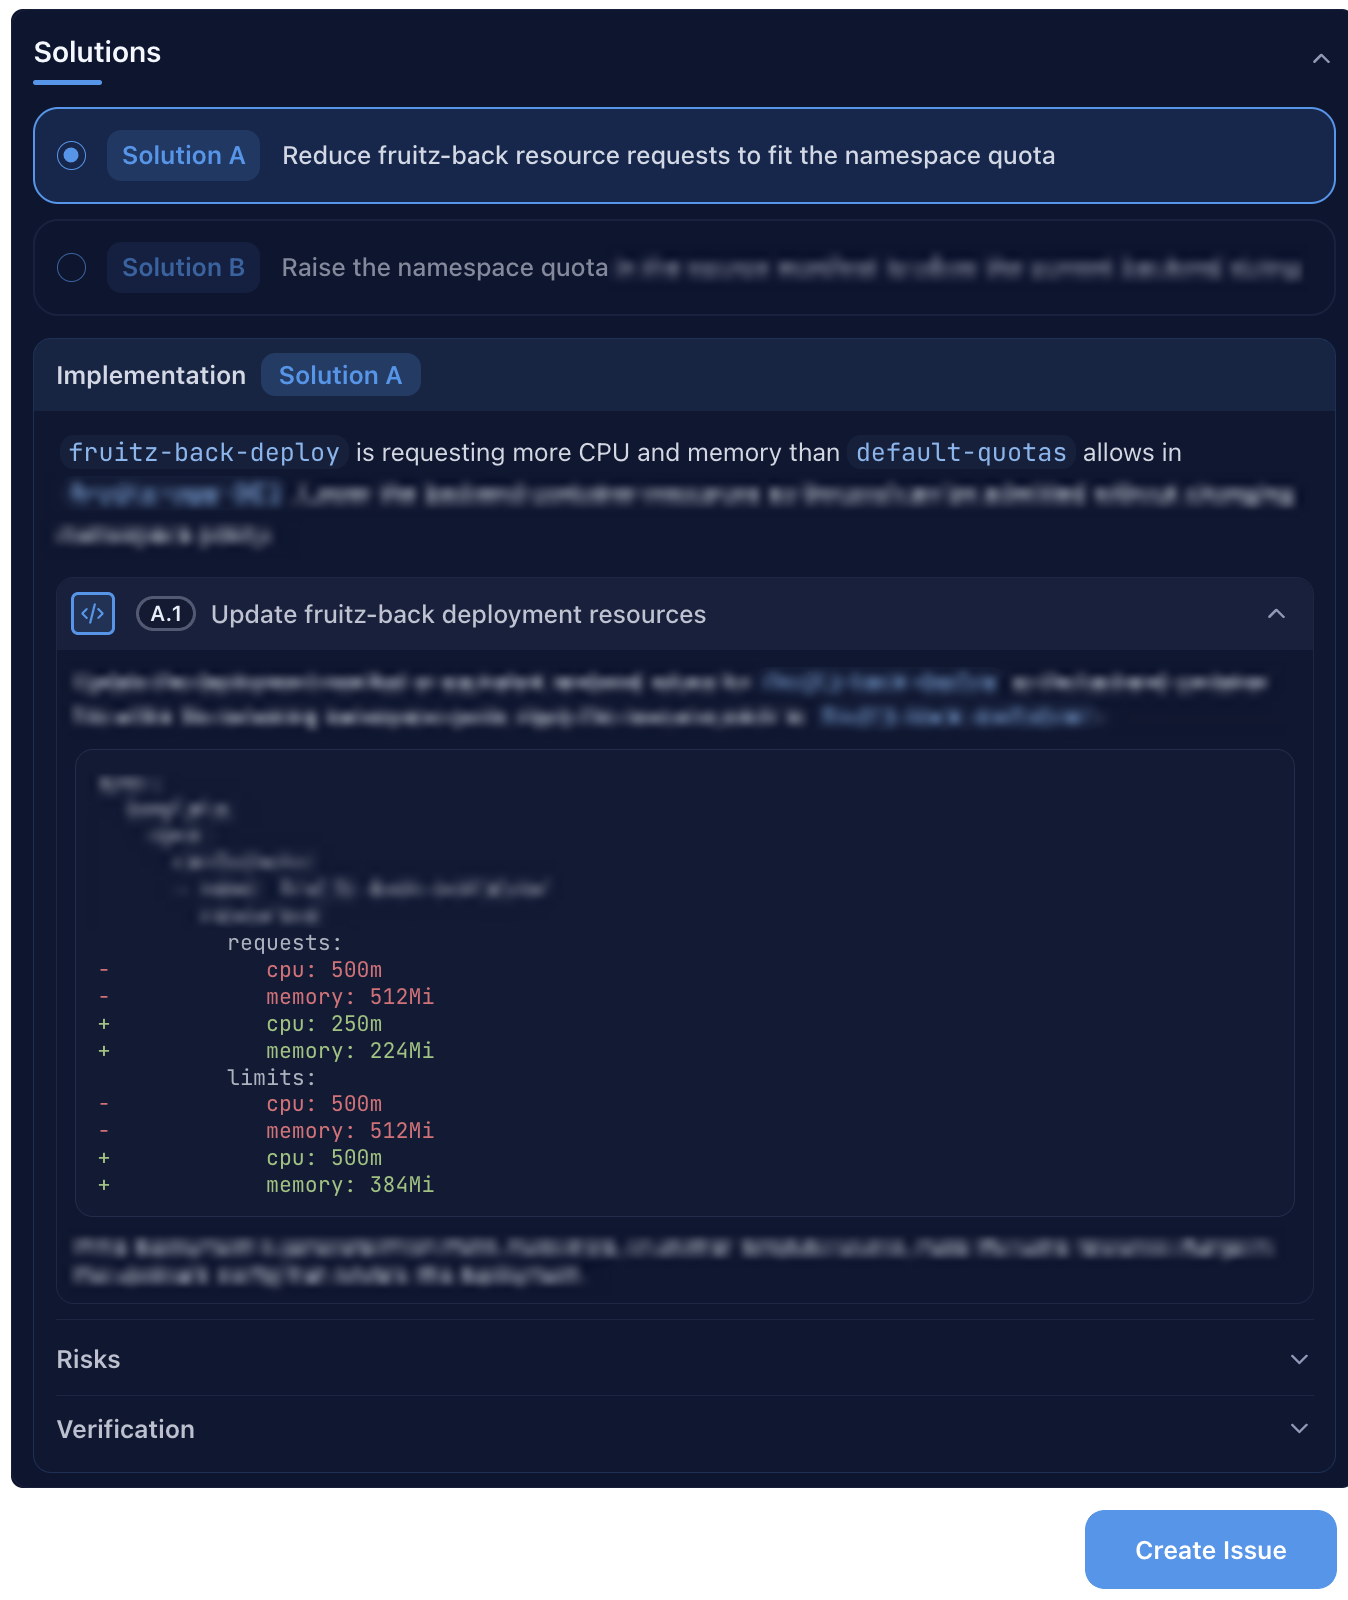
Choisissez parmi des correctifs déjà élaborés.
Réfléchir à la bonne approche évite qu’un mauvais correctif n’atteigne un système en production et n’y fasse plus de dégâts que la panne qu’il devait résoudre.
- Du diagnostic à la remédiation Une fois la cause identifiée, l’agent propose une solution que vous pouvez retravailler ensemble.
- Des recommandations adaptées à votre environnement La solution proposée tient compte de votre stack technique, versions et infrastructure. L’agent peut aussi consulter les runbooks de diagnostic et les incidents passés de votre organisation.
- Un plan d’action prêt à l’emploi Une solution se décompose en une séquence d’étapes détaillées.
- Des solutions ordonnées par risque Quand plusieurs approches sont possibles, la moins risquée est proposée en premier.
- Une pratique GitOps renforcée Les agents NeuroKube suivent les principes GitOps et privilégient les correctifs implémentables sous forme de code. Un plan peut malgré tout combiner des actions de stabilisation immédiates et un correctif durable en code.
- Convertissez le rapport en issue Git Elle contient la solution retenue et fournit le contexte pour la suite du workflow. Fonctionne avec GitLab, GitHub et d’autres plateformes Git.
Implémentation
Le bon correctif, implémenté pour vous.
Tout le monde sait que le correctif a sa place dans Git. Mais l’incident dure, et quelques commandes suffisent à le régler directement sur le cluster : pas de code inconnu à comprendre, pas d’effet de bord inattendu, pas de tests à concevoir. Seulement, un correctif appliqué ainsi ne laisse aucune trace.
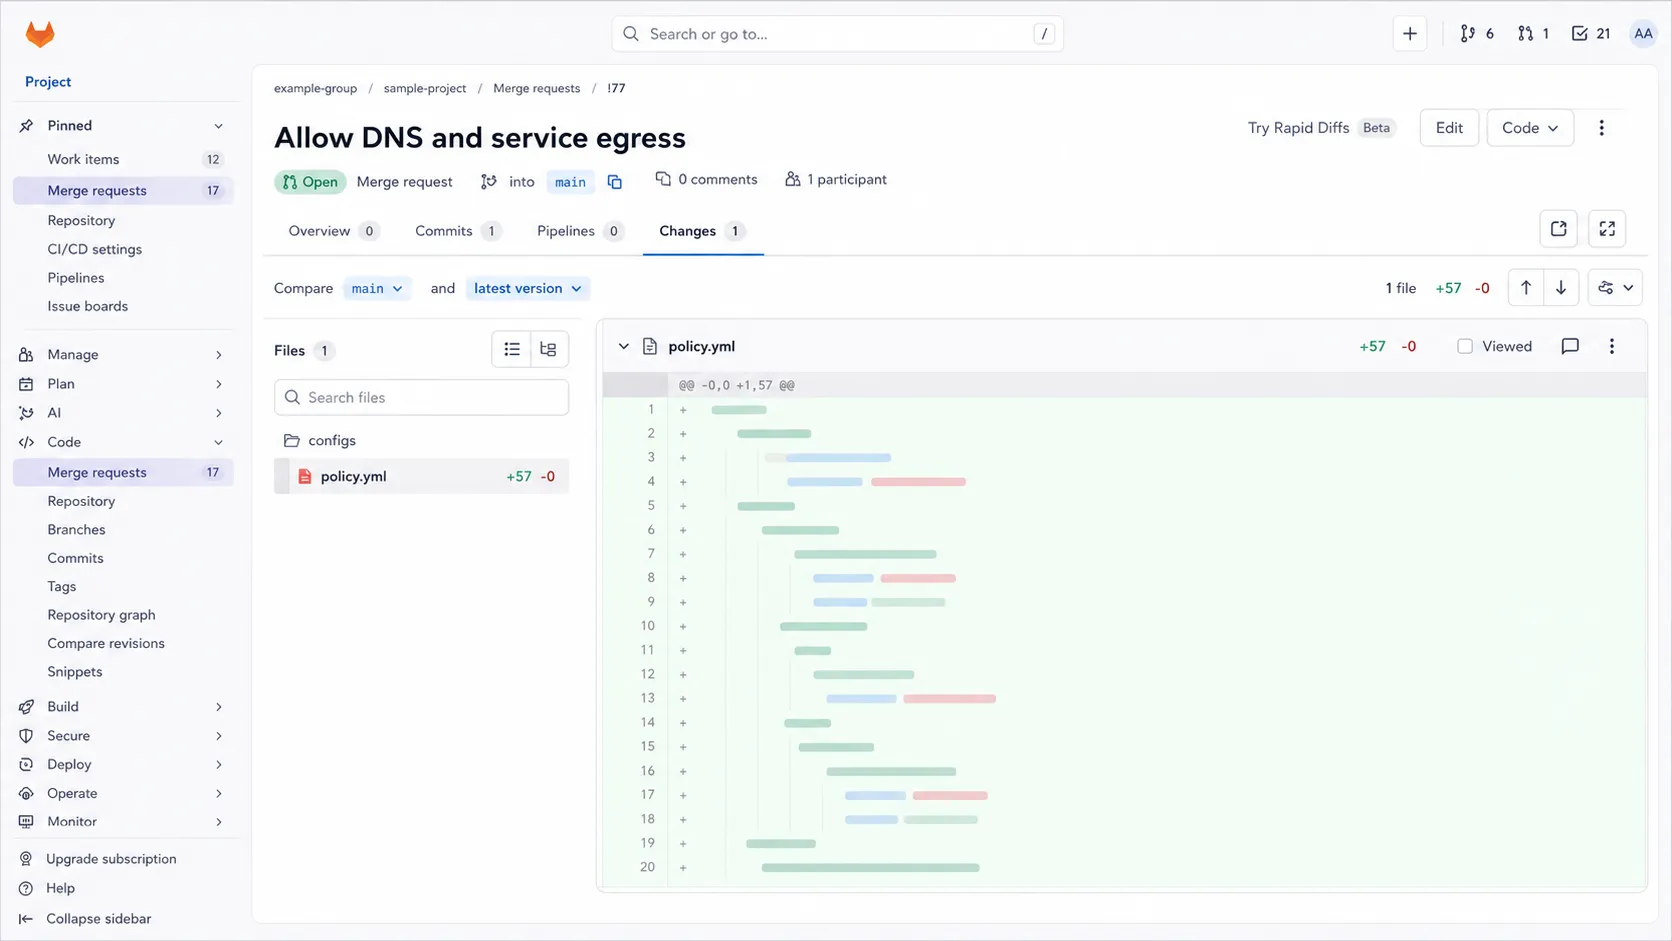
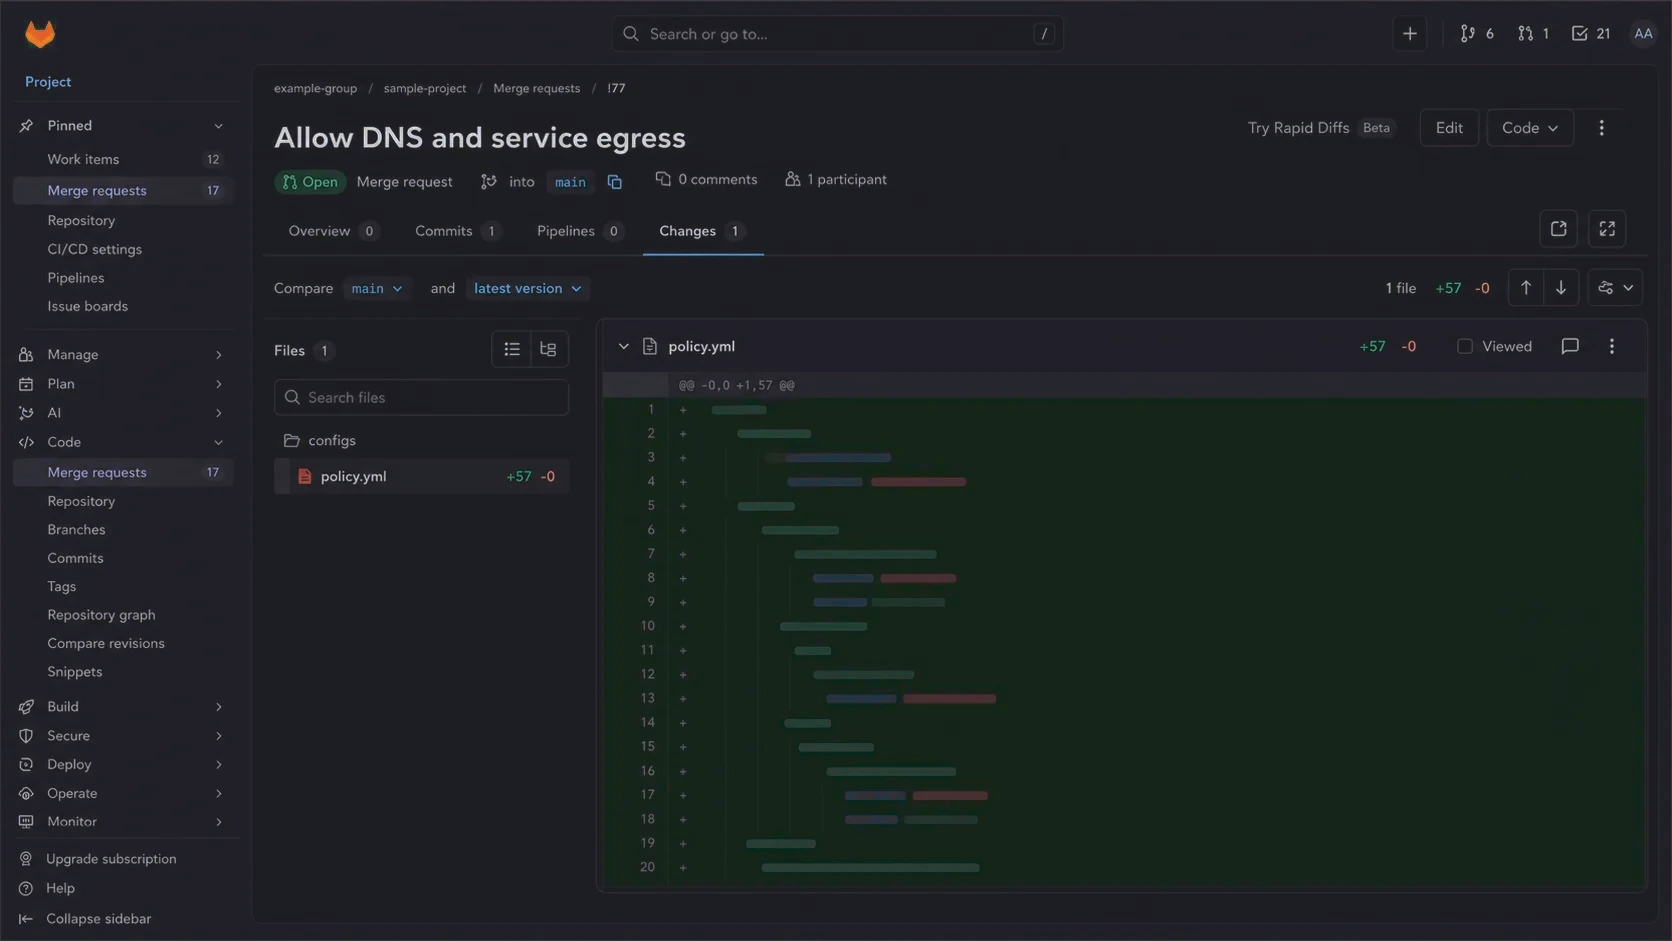
- Assignez l’issue à l’agent de code Il implémente le correctif décrit et ouvre une change request prête pour la revue de code.
- Un correctif qui laisse une trace Il est visible de toute l’équipe, réversible, et il survit au prochain déploiement. Toute erreur que votre pipeline CI/CD intercepte n’atteint jamais votre cluster.
- Des outils sandboxés L’agent modifie les fichiers source et exécute des commandes dans un conteneur isolé de la machine hôte.
- Pas de tokens gaspillés en tâches mécaniques Création de branche, commits, ouverture de la change request : les actions Git sont exécutées par du code, pas par l’agent.
Revue de code
Gardez la main sur votre code.
Qui dirige : vous, ou l’agent de code ? La réponse est dans la revue de code.
Décidez de ce qui part en production et de la façon dont c’est construit.
- Faites vos retours sur la change request Relancez l’agent de code pour qu’il les prenne en compte, autant de fois que nécessaire.
- Mergez quand vos exigences sont remplies Votre processus de revue s’applique : mêmes règles d’approbation, mêmes contrôles.
Validation
Vérifiez le correctif, devancez l'alerte.
Un pipeline vert et un déploiement réussi ne veulent pas dire que l’incident est résolu.
Sans nouvelle alerte, on considère que le correctif a fonctionné. Quand une alerte finit par arriver, la preuve de son échec vient trop tard.
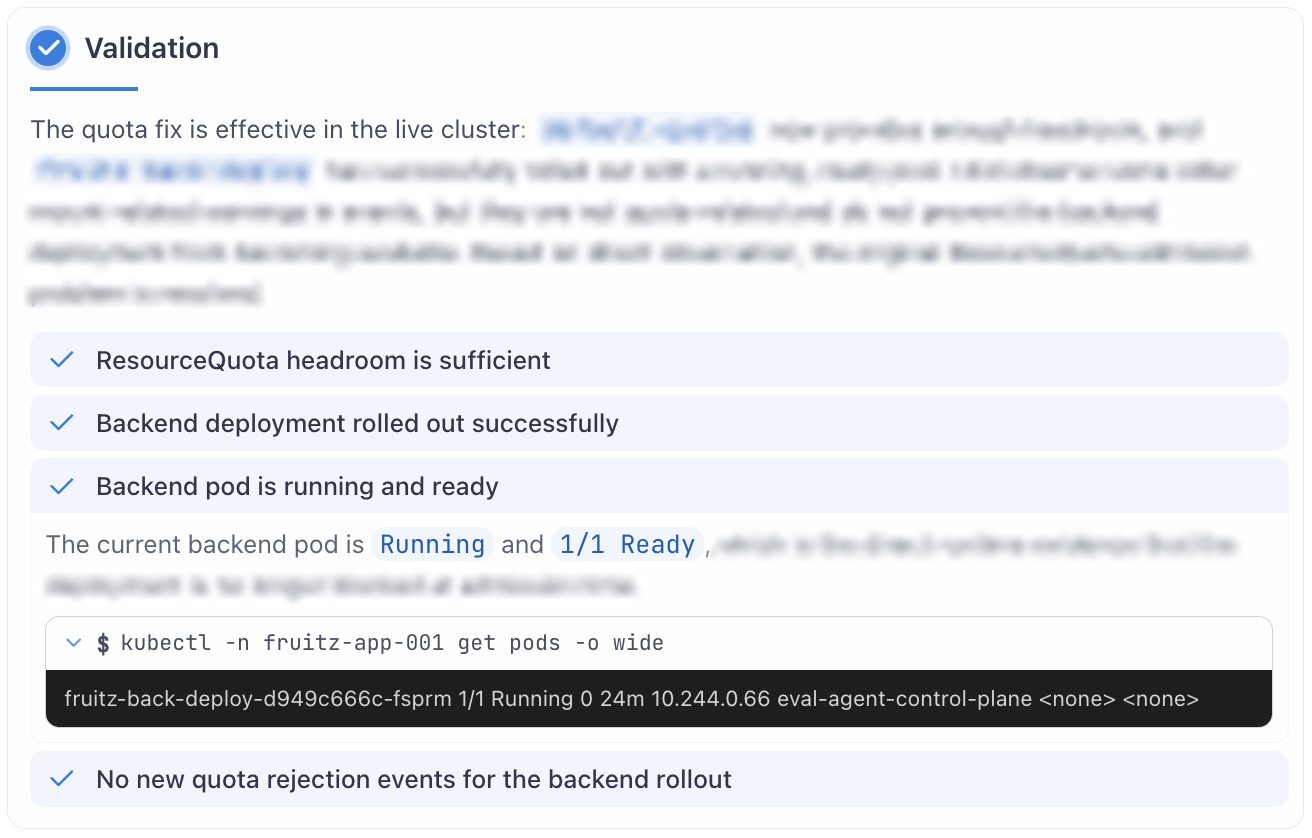
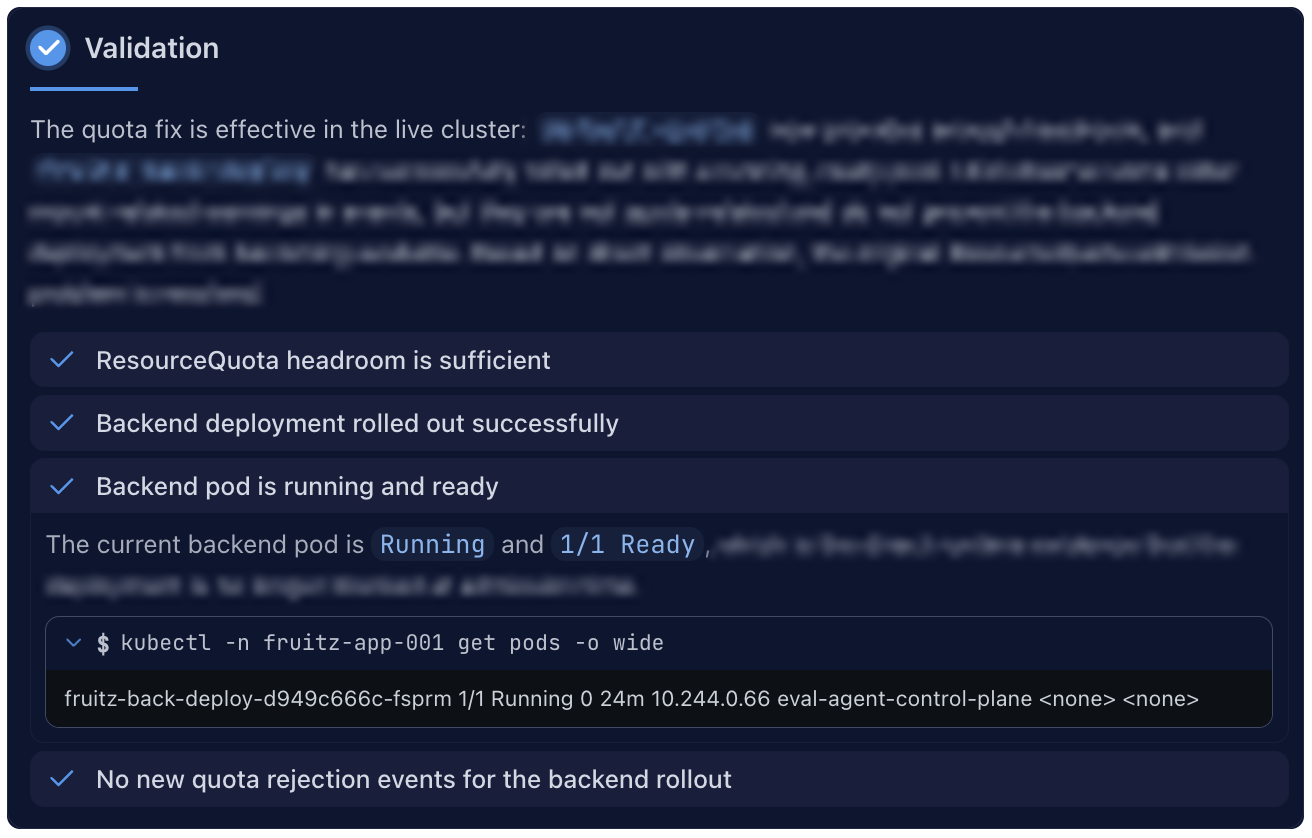
- Résolution vérifiée sur le cluster L’agent de validation inspecte le cluster pour confirmer que les symptômes ont disparu et le fonctionnement est rétabli.
- Pas de checklist figée L’agent déduit ce qu’il faut vérifier à partir de l’issue et des changements déployés, pour chaque incident.
- Un verdict vérifiable Retracez le raisonnement de l’agent d’après les contrôles effectués et leurs résultats.
- Relancer une investigation si le problème persiste Le contexte actuel est transmis à la nouvelle session de troubleshooting : l’agent sait ce qui a déjà été tenté et ne repart pas de zéro.
- Nettoyage automatique Une résolution validée clôture l’incident, son issue et sa change request, ainsi que les autres tentatives sur le même problème.