Résoudre tous vos incidents Kubernetes dans un contexte Entreprise
La plateforme IA pour Kubernetes et les stacks cloud-native. Elle automatise le travail de troubleshooting et de résolution, du premier signal au correctif vérifié. Vous restez aux commandes.
Les experts plateforme sont rares, difficiles à recruter et à garder
Avec environ un ingénieur plateforme pour dix développeurs, tous les problèmes non triviaux convergent vers les mêmes personnes. Elles concentrent tout le savoir-faire de l'entreprise. Un goulot qui se resserre à mesure que la plateforme grandit et se complexifie : plus d'outils à maîtriser, plus de points de défaillance, plus de signaux dispersés à réassembler. Entre les clusters, les dépôts Git, l'IaC et les outils d'observabilité, chaque source supplémentaire allonge le temps de résolution.
NeuroKube aide les équipes à résoudre les incidents plus vite et étend l'expertise opérationnelle à toute l'organisation. Le goulot se desserre, le savoir-faire reste.
Aujourd'hui
Opérer des plateformes modernes
- Un troubleshooting manuel
- La complexité croissante et des outils cloisonnés, qui compliquent le diagnostic
- Des problèmes non triviaux qui remontent toujours aux mêmes experts
- Les connaissances critiques concentrées sur quelques personnes
- Des investigations qui partent de zéro, sans mémoire des cas déjà traités
Avec NeuroKube
Intelligence opérationnelle à l'échelle de l'organisation
- Une résolution autonome de bout en bout, sous contrôle humain. Plus rapide et toujours rigoureuse
- Tous les signaux pertinents recoupés depuis un seul endroit : de meilleures décisions, moins de charge cognitive
- Une résolution standardisée et guidée par l'IA, à la portée d'un plus grand nombre
- Les connaissances consignées automatiquement et mises à disposition de tous
- Des résolutions de plus en plus précises et efficaces grâce aux incidents passés
Capacités
Troubleshooting & résolution autonomes
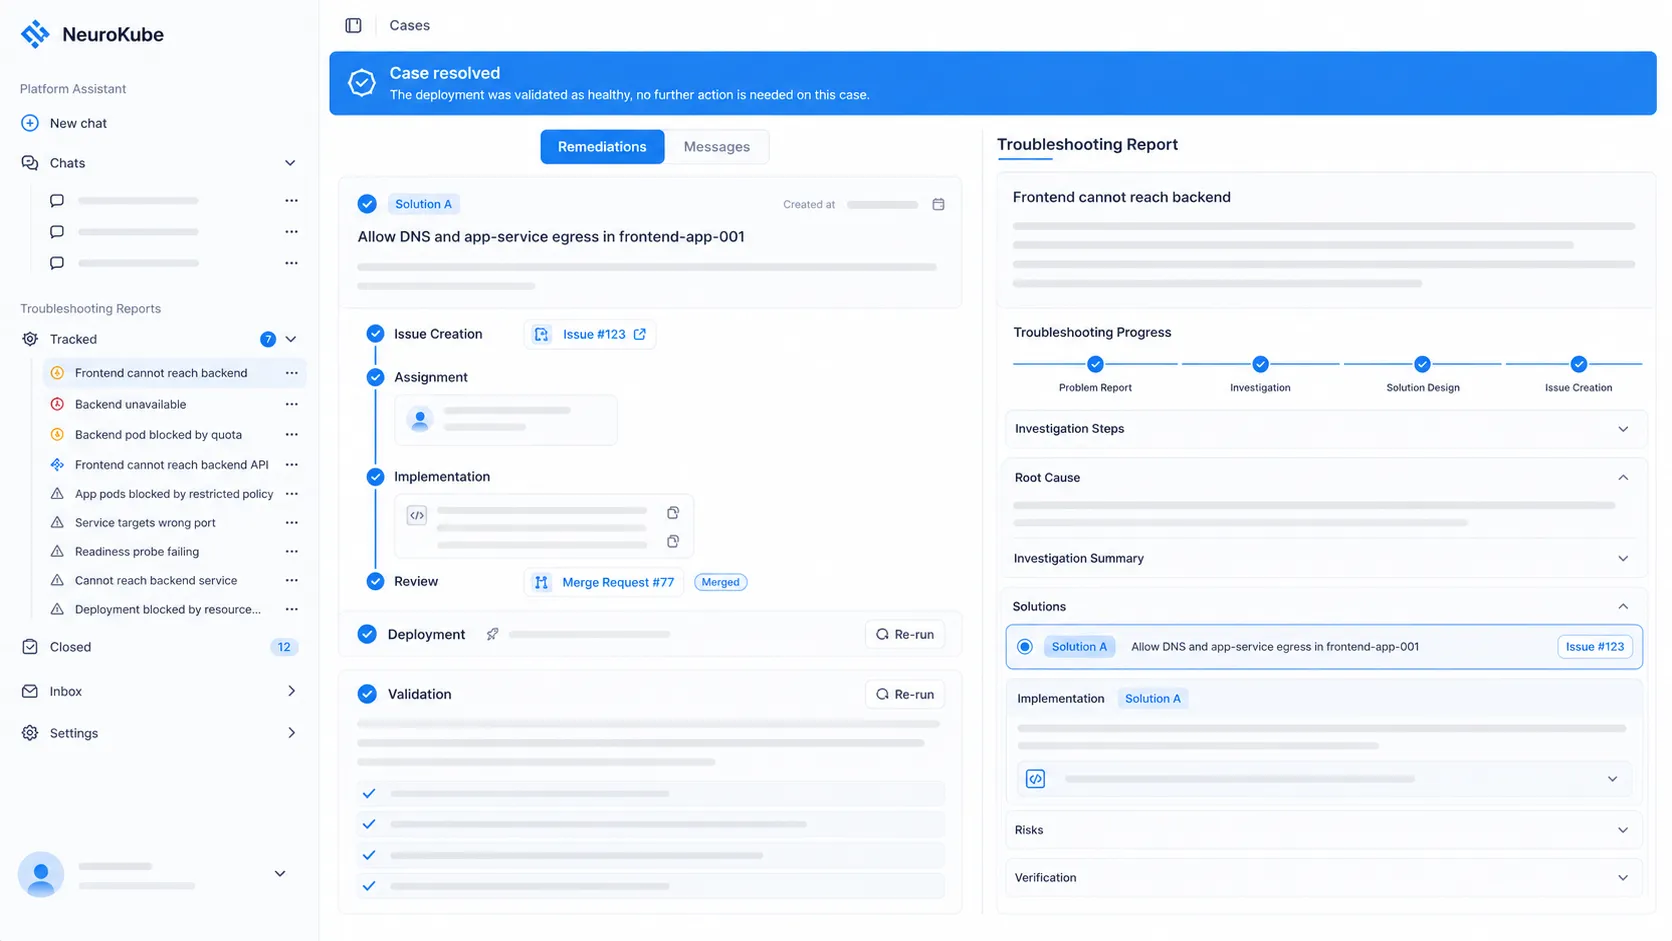
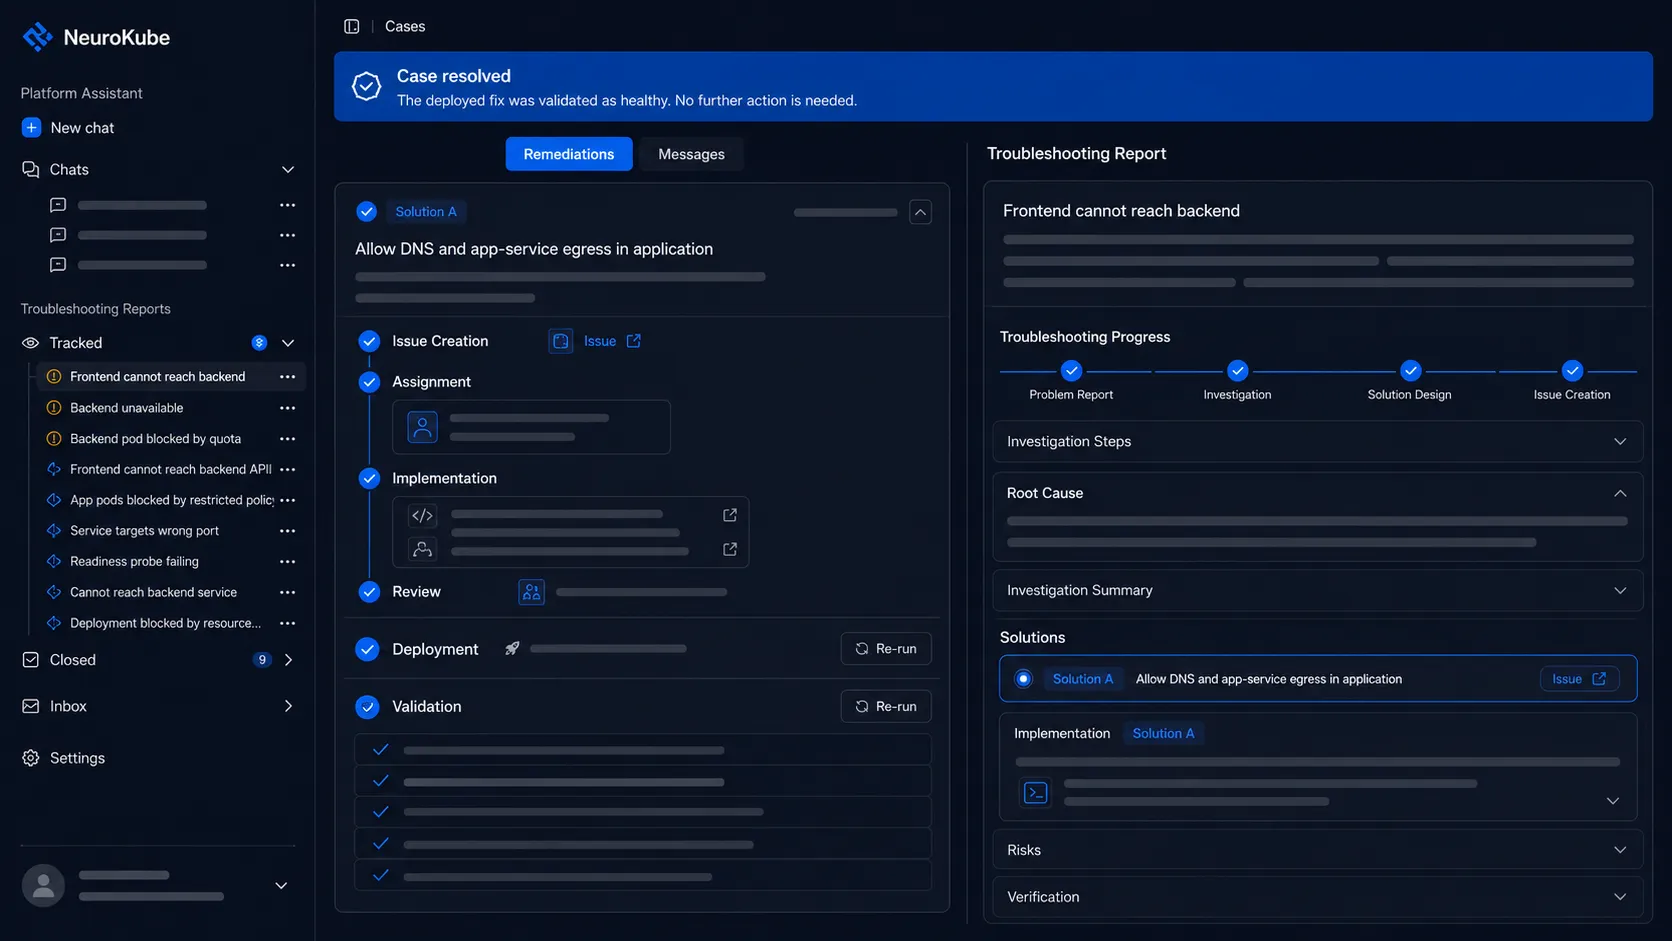
Résolvez plus d'incidents, plus vite et avec la même rigueur, jour et nuit. Au niveau d'automatisation qui vous convient.
- Protocoles de troubleshooting pour une qualité constante
- Analyse de la cause racine vérifiable, fondée sur des preuves
- Plans de remédiation prêts à l'emploi et ordonnés par risque
- Rapport de troubleshooting structuré pour une relecture rapide
- Implémentation automatisée du correctif
- Validation automatisée du correctif et nouvelle investigation en cas d'échec
- Déléguez aux agents ou travaillez avec eux
- Intervenez ou reprenez la main à tout moment
Une analyse croisée de vos systèmes
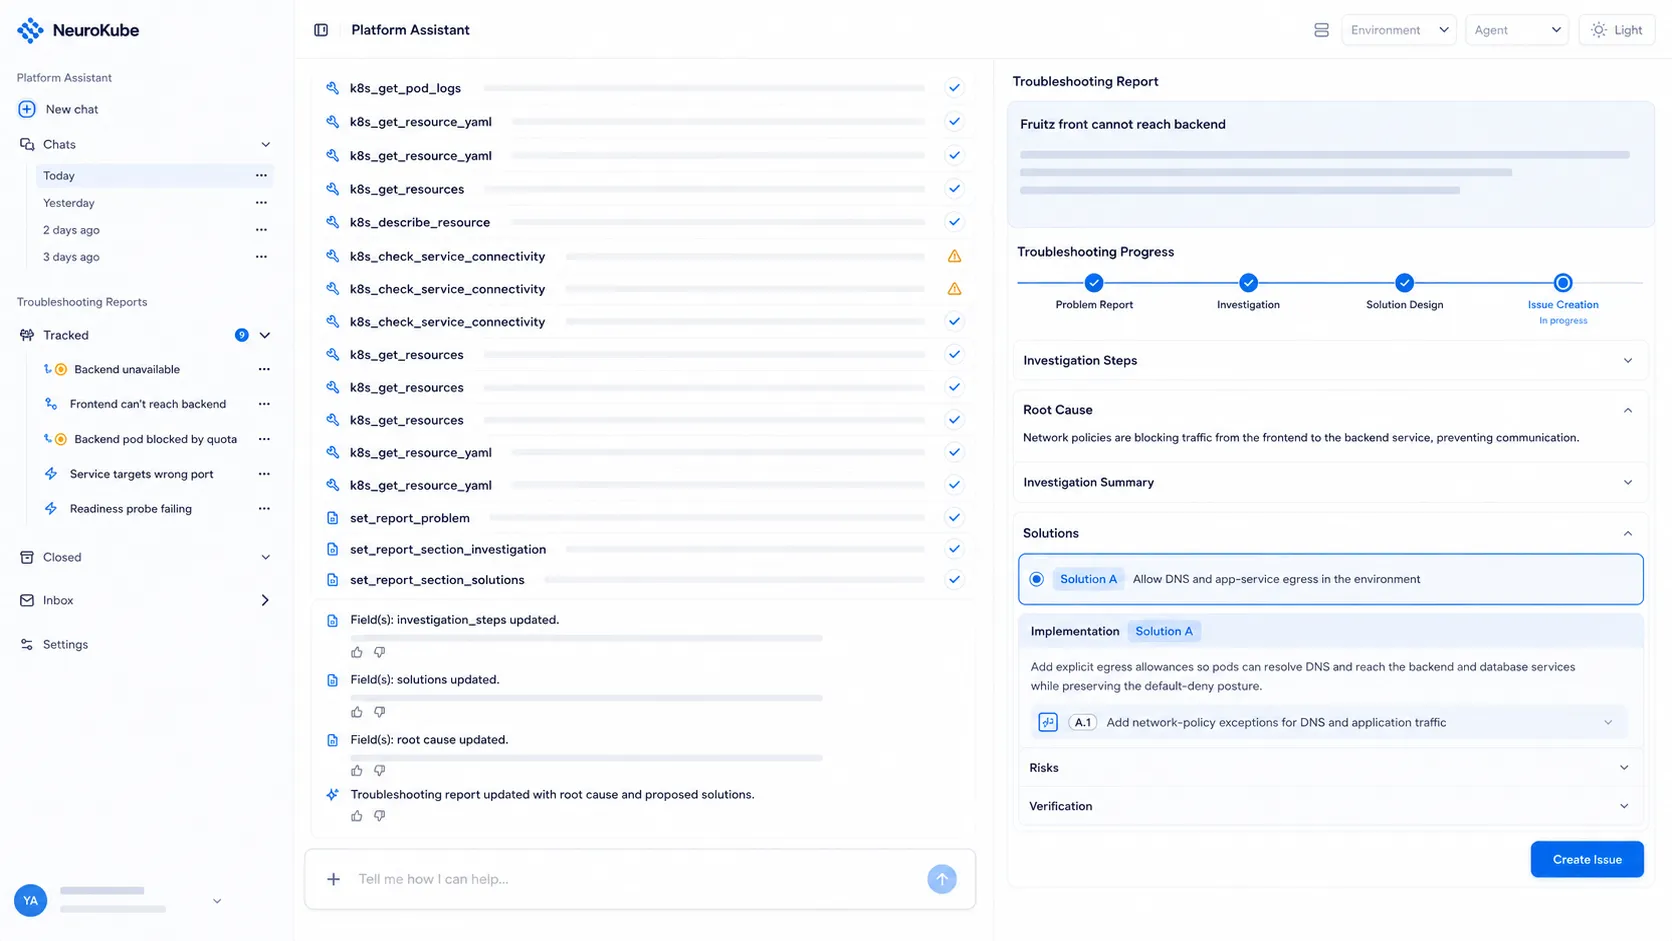
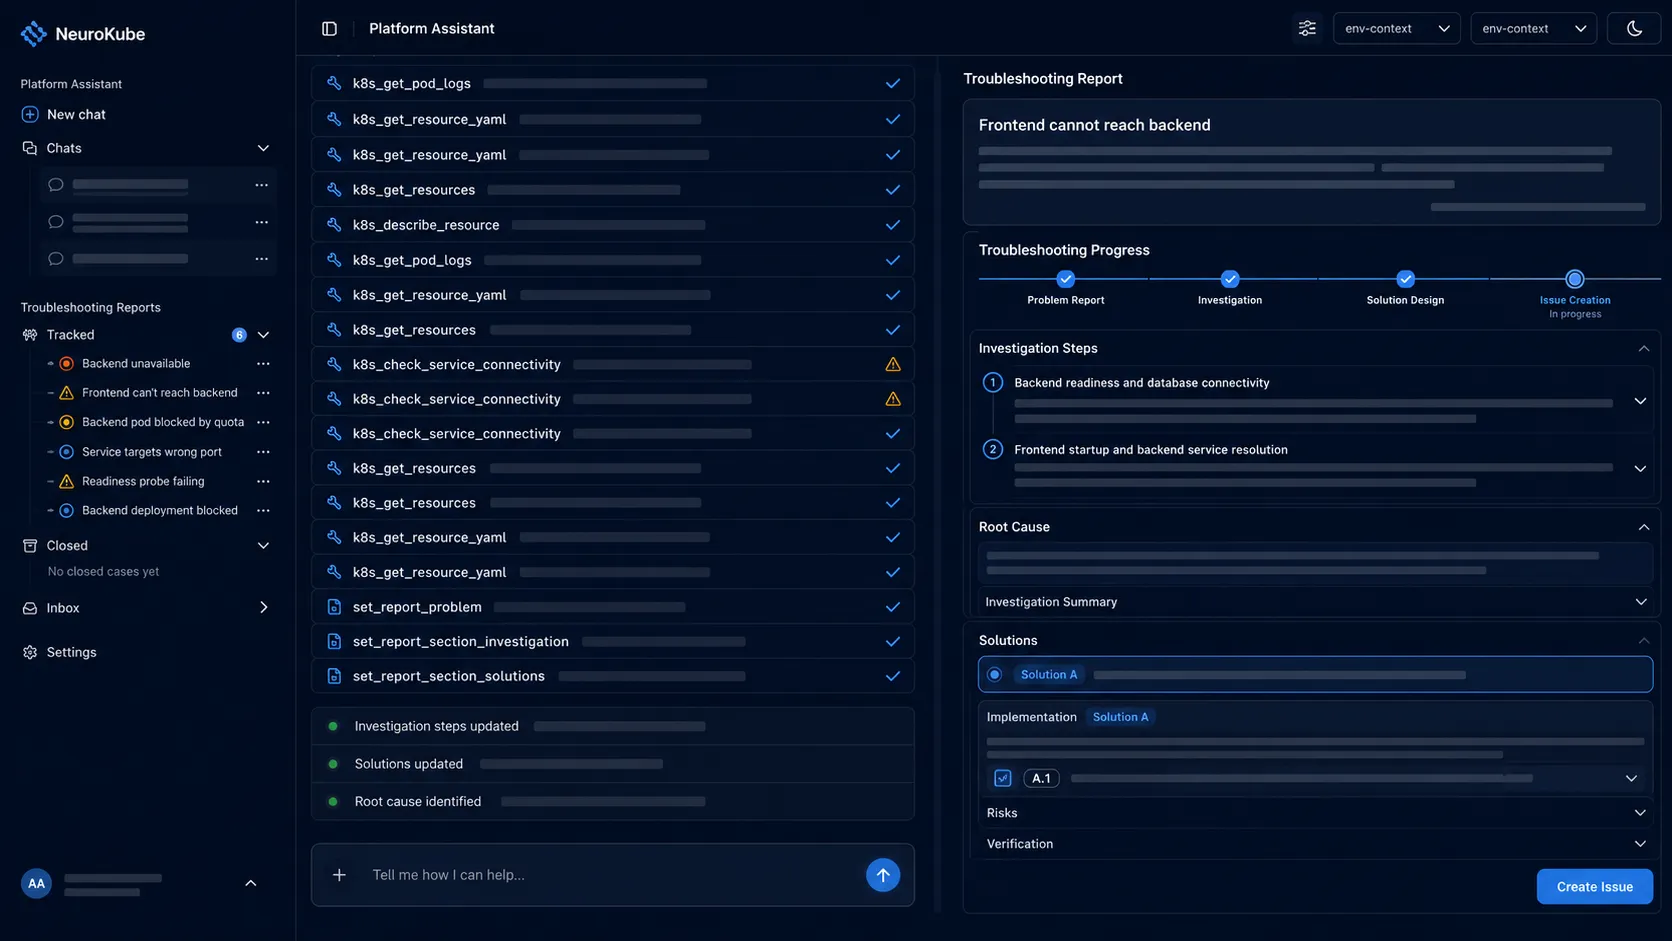
Une vue complète de votre plateforme depuis un seul endroit : état des clusters, logs, métriques, historique des déploiements et dépôts Git.
- Relier des signaux dispersés et hétérogènes
- Multi-cluster et multi-environnement
- Un agent spécialisé par composant
- Une architecture extensible pour couvrir toute votre stack
Les bonnes pratiques appliquées
Le même workflow d'exécution à chaque fois, calqué sur les pratiques GitOps éprouvées. Prévisible, sans tokens gaspillés.
- Les mêmes étapes d'un incident à l'autre
- Un processus de résolution partagé
- Des issues Git systématiquement renseignées
- Votre équipe guidée à chaque étape
- S'intègre à votre GitOps existant
- Des tokens dépensés à raisonner, pas à orchestrer
Un savoir-faire collectif qui se capitalise
Chaque incident renferme une connaissance réutilisable, exploitée par la plateforme et qui reste après les départs.
- Des enseignements tirés de chaque cas clôturé
- Des recommandations de résolution issues de cas similaires
- Une précision qui croît avec le nombre d'incidents
- Moins de temps et de tokens perdus en explorations inutiles
- L'expertise reste dans l'entreprise
- Un savoir-faire de niveau senior accessible à toute l'organisation
Une base de connaissances consultable à la demande
Si nécessaire, les agents ancrent leurs réponses dans la documentation propre à vos versions, les standards du secteur et votre documentation interne : références d'architecture, post-mortems, politiques.
- Une documentation air-gapped correspondant à votre stack
- Moins d'hallucinations quand les composants sont peu courants
- Indexation des espaces wiki internes et des documents de votre choix
- Des documents recherchables dès leur dépôt dans votre workspace
- Des réponses respectant vos contraintes, conventions et versions
- Des modèles qui connaissent votre contexte : architecture, procédures, intégrations, choix de conception…
- Une base de connaissances interrogeable directement par votre équipe
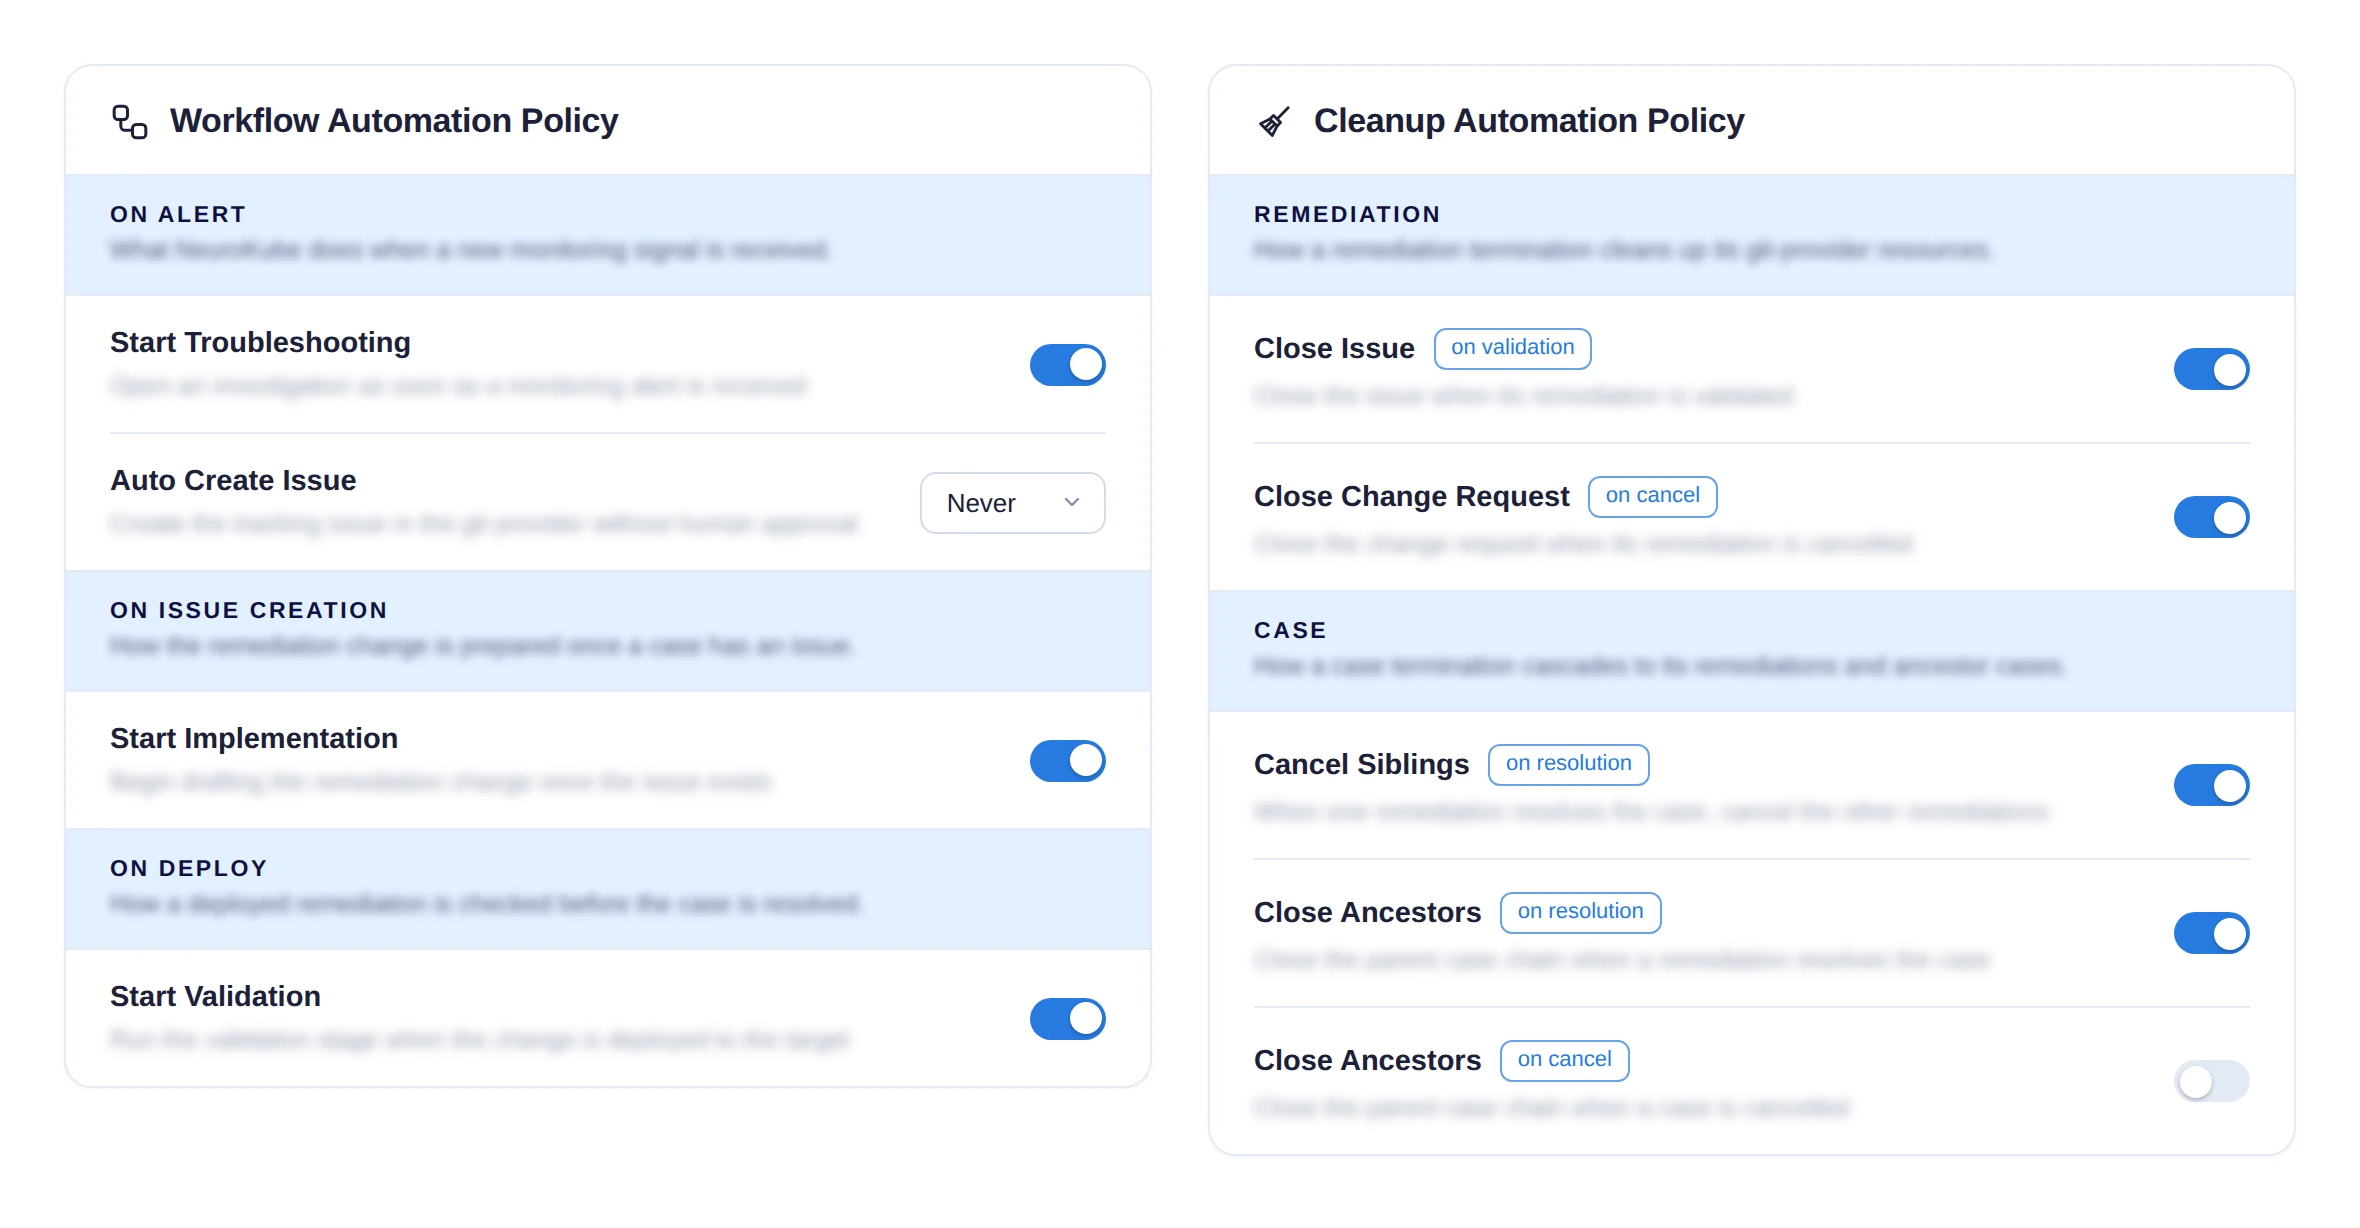
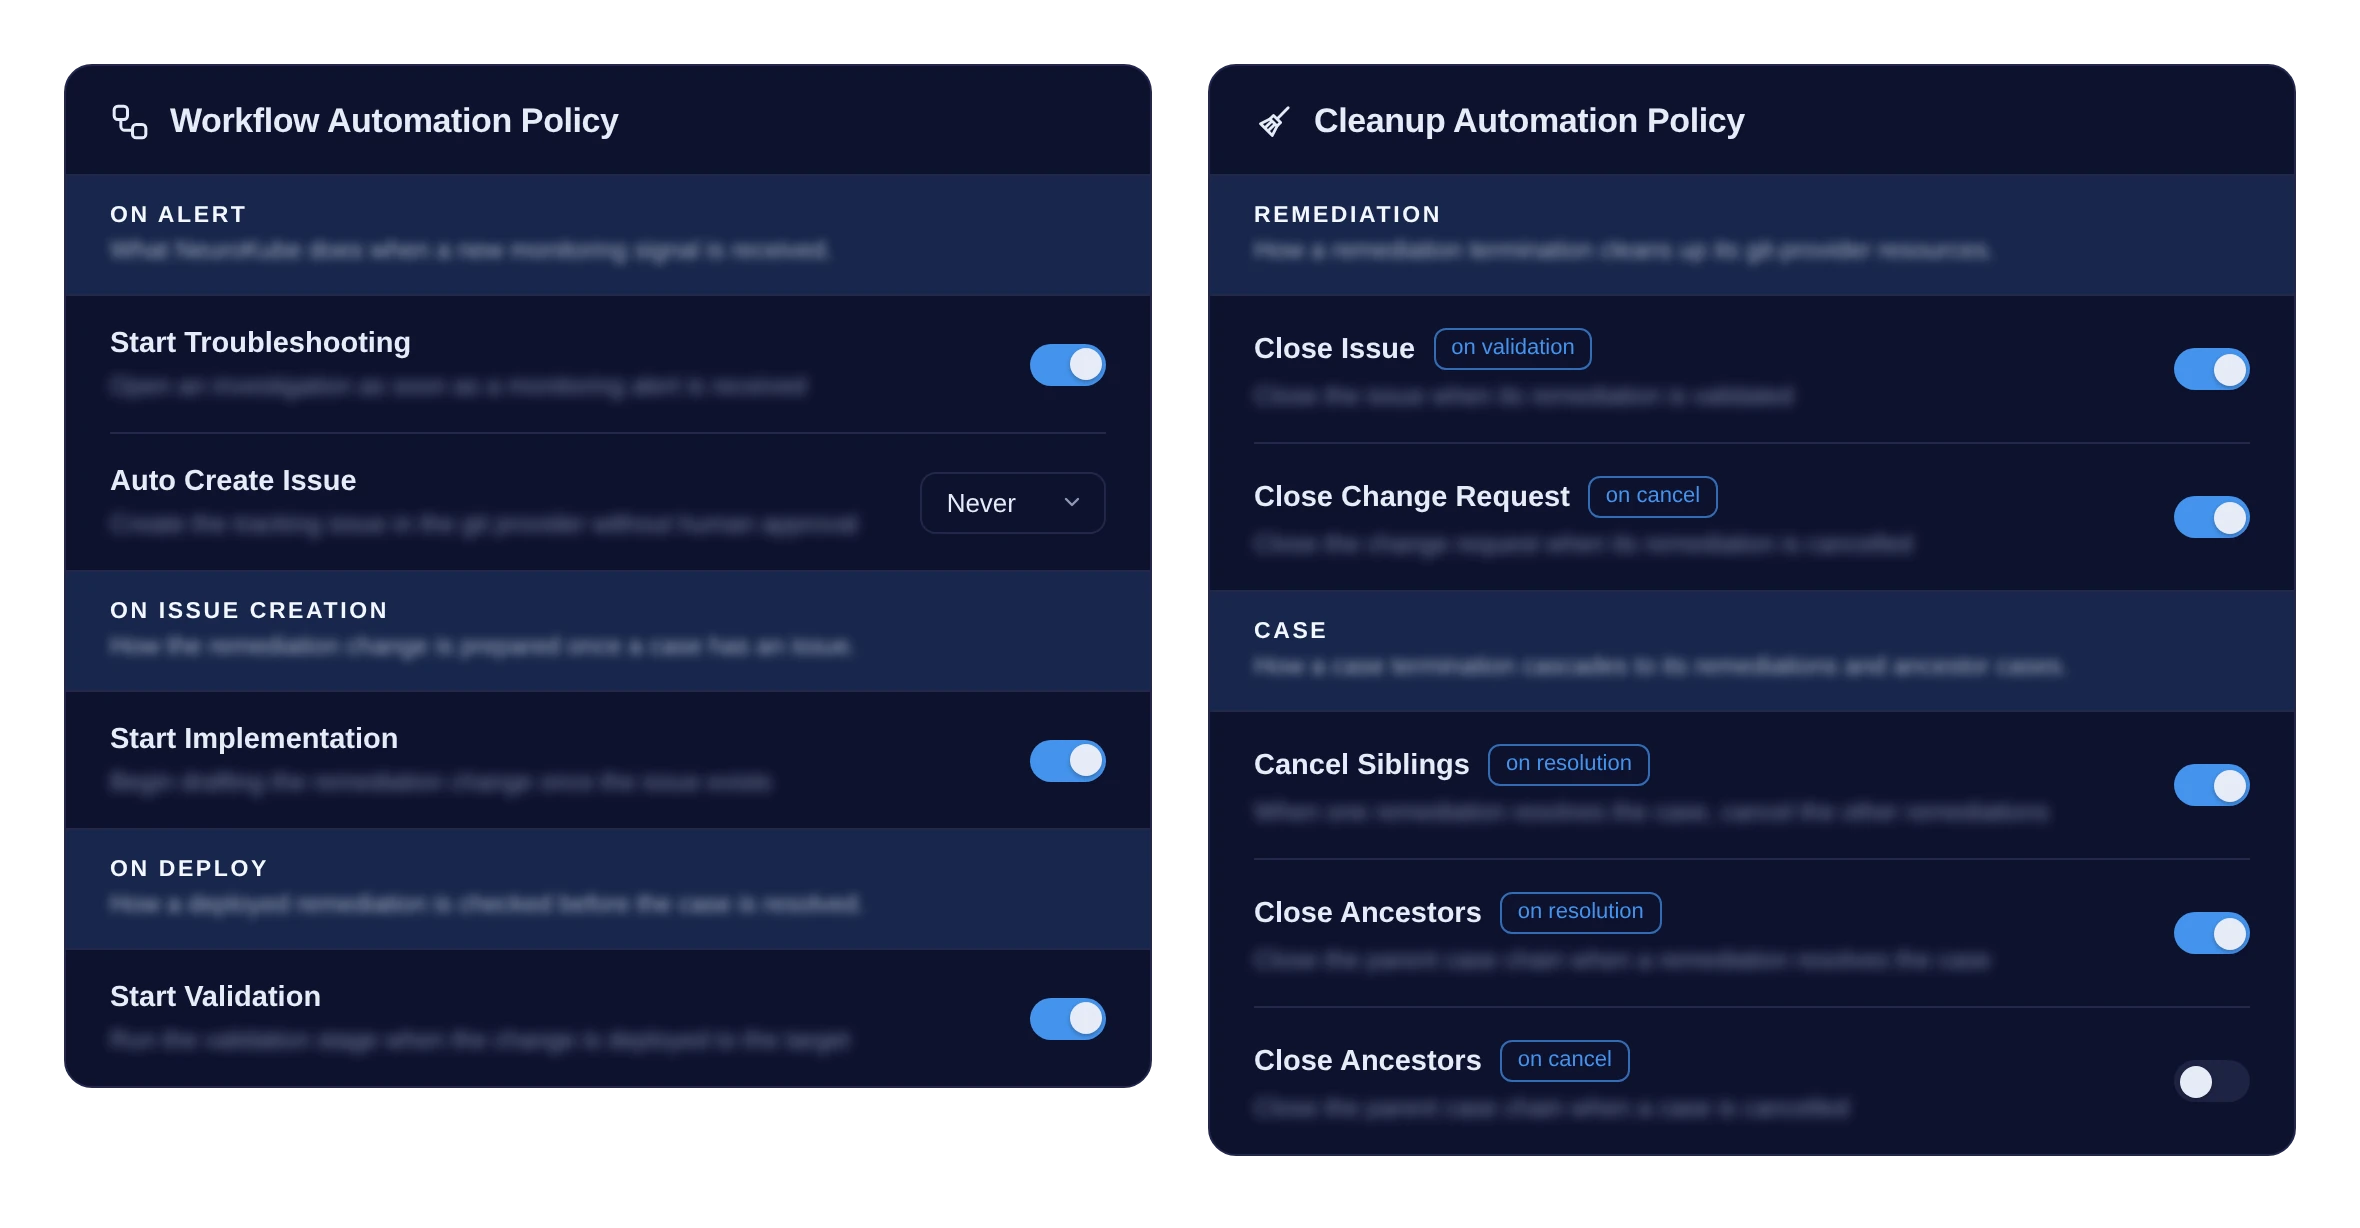
Contrôle ajustable et gouvernance
Ne sacrifiez pas le contrôle ni les règles de sécurité élémentaires pour des fonctionnalités. Ajustez le niveau d'automatisation en fonction des projets, exigez plusieurs niveaux de protection et un contrôle d'accès.
- Niveau d'automatisation réglable selon le profil de risque
- Outils en lecture seule par défaut
- Outils d'écriture et d'exécution sandboxés
- Authentification
- Contrôle d'accès granulaire
- Traçabilité complète
- Le modèle de votre choix
- FinOps et observabilité
Un système agentique, pas un simple wrapper autour d'un modèle
Impact
Quel que soit votre point de départ, nous travaillons avec vos équipes pour pousser vos résultats aussi loin que possible.
3× – 10×
Résolution plus rapide (MTTR)
20% – 50%
Moins d'escalades
𝗡× ➚
Plus de temps pour ce qui compte
L'expertise et le bon contexte, entre toutes les mains
- L’expérience d’un senior à chaque étape
- La vue d’ensemble depuis un seul endroit
- Des connaissances opérationnelles qui restent
- Plus performant à chaque incident
Le contrôle préservé
- Les décisions à fort enjeu restent humaines
- Des ingénieurs qui progressent, pas mis de côté
- Une automatisation qu’on augmente à mesure qu’elle fait ses preuves
Les bonnes pratiques renforcées
- Des changements en code, revus et réversibles
- Le même processus de résolution à chaque fois
- Une traçabilité du signal au correctif
- Outils en lecture seule par défaut, le reste en sandbox